边端AI拐点将至:物理AI呼唤“下沉算力”,国产厂商亮剑! - 智东西
Quick Answer
Aixin Yuanzhi launched its AX8860 series edge AI chips with 256TOPS peak performance, targeting industrial applications where data security and latency are critical.
Quick Take
The chips support advanced models like DeepSeek-V4-Flash and aim to enhance real-time decision-making at the edge, reducing reliance on cloud computing.
Key Points
- AX8860 chips achieve 256TOPS peak performance and support FP4 precision.
- The series includes AX8860P and AX8860, designed for edge computing applications.
- Aixin Yuanzhi emphasizes low power consumption, operating at 45% of leading GPUs.
- The chips facilitate real-time decision-making, crucial for industrial environments.
- Aixin Yuanzhi's platform supports various models, enhancing deployment flexibility.
📖 Reader Mode
~3 min read
芯东西(公众号:aichip001)
作者 | 李水青
编辑 | 漠影
近来,AI在云端的能力边界不断被推高,但当智能走进真实生产场景,新的问题浮现:数据传输需要时间,敏感信息不宜离开现场,持续调用云端模型的成本也并非所有企业都能承担。
当AI开始接管真实世界的任务,算力应该部署在哪里?这成为一个绕不开的问题。
底层硬件厂商正从更近的“现场”找解法。10月16日工博会,国内边端AI推理芯片厂商爱芯元智推出AX8860系列大算力边缘计算芯片,混合精度算力达256TOPS,双芯互联可支持2840亿参数规模的DeepSeek-V4-Flash等模型运行。

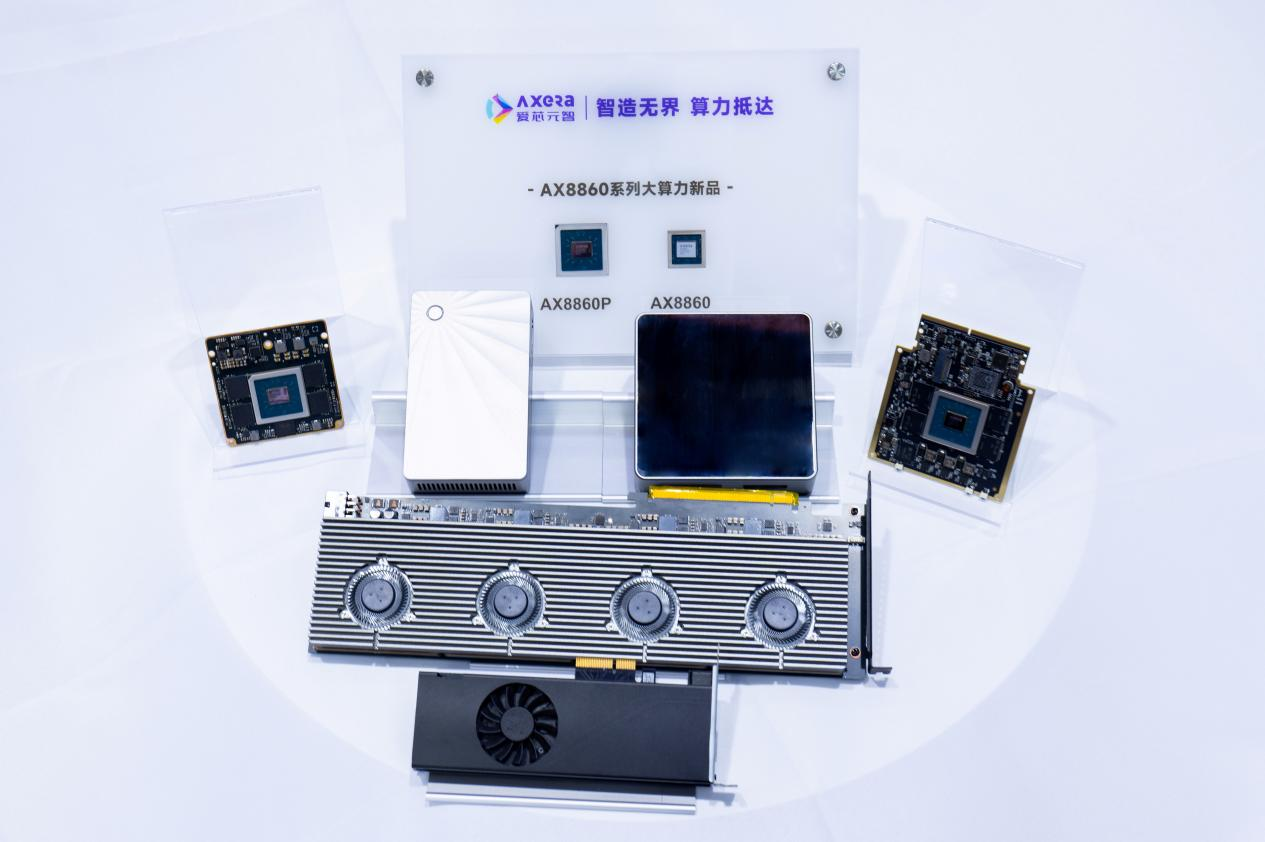
该公司还同步展出A256S核心模组、PCIe推理卡及Agentic Box等硬件形态,试图把更强的模型推理能力带到离数据和执行设备更近的地方。
256T峰值算力、原生FP4支持、273GB/s内存带宽、128GB LPDDR5X内存,以及支持多芯级联的设计……爱芯元智推出的AX8860系列的目标,是让边缘设备承载更大规模的模型,同时兼顾功耗、部署效率和实际推理表现。
不得不说,当边缘算力接近具备对标云端的能力,物理AI的算力底座正在夯实。
物理AI是大方向,更准确的落点是边缘和端侧AI。爱芯元智创始人仇肖莘在采访中提到,爱芯元智定位为边缘推理芯片基座产品的平台型企业,公司不止布局车载领域,还有边缘计算和终端计算两大业务,并为更前沿的机器人、智能设备等方向做技术储备。
▲爱芯元智创始人仇肖莘
随着AX8860系列全新发布,爱芯元智已拥有面向边缘计算场景、算力覆盖十几TOPS到数百TOPS的产品平台。
AI在云端数据中心的表现已经让数学家、物理学家和科技从业者感到惊叹。可进入真实生产场景,延迟、安全、成本三座大山横亘在AI与真实世界之间。
在10月16日的新品发布会上,仇肖莘谈到了公司布局边缘计算的初衷。对于很多工业和终端场景而言,数据上传、云端推理、结果回传,再到设备执行,整个过程不仅存在时延,也涉及数据安全和持续推理成本。
以工业产业场景为例,不同工业产线对应的模型各不相同,都属于场景定制化模型,因此模型快速部署能力至关重要;产线缺陷检测对时延要求极高,需高速识别零件缺陷并及时分流;工业现场数据不宜传出厂区,云端推理存在数据泄露风险;持续上云调用还会带来不菲的推理成本。
因此,爱芯元智提出了“现场智能”的概念。
什么叫现场智能?在事件发生的现场准确捕捉事件,根据周围环境做现场判断,根据判断指挥设备或机器做执行。现场时间、现场判断、现场执行,三者合一,才构成物理AI的完整定义。

要满足现场智能,仇肖莘总结四个关键要素:一是感知全,不止摄像头,雷达、触觉、压力等传感器都要采集环境信息;二是算得准,模型误判在工业、机器人场景下下会直接影响执行,容错远低于对话应用;三是反应快,产线、自动驾驶、机器人等场景,决策需要做到毫秒级;四是执行稳,整条决策链路要持续可靠,支撑设备长时间连续运行。
而边缘计算的意义,正是在这条“现场智能”的链路中提供靠近现场的计算能力。
这也意味着,边缘AI的价值不能只看部署位置。更重要的是,它能否在现场完成感知、推理与执行的闭环,让智能从提供建议进一步走向参与实际生产,带来经济增长。
二、AX8860系列破局:边缘算力堪比云端,不堆峰值拼效率
如果说现场智能提出了边缘计算的需求,那么AX8860系列试图回答的,就是如何用一颗芯片承载更强的边缘推理能力。
爱芯元智此次发布的AX8860系列包含AX8860P和AX8860两款芯片。按照仇肖莘的介绍,这一系列历经15个月研发,核心设计思路是同时兼顾峰值算力、内存带宽和芯片架构效率。
该芯片支持256T峰值算力,支持混合精度。在边缘计算领域,这是首批原生支持FP4计算精度的芯片之一。
FP4对大模型部署非常有利。只要对应的开源模型原生支持FP4,经过适配后,用户就可以直接在爱芯元智芯片上获得使用FP4的好处。
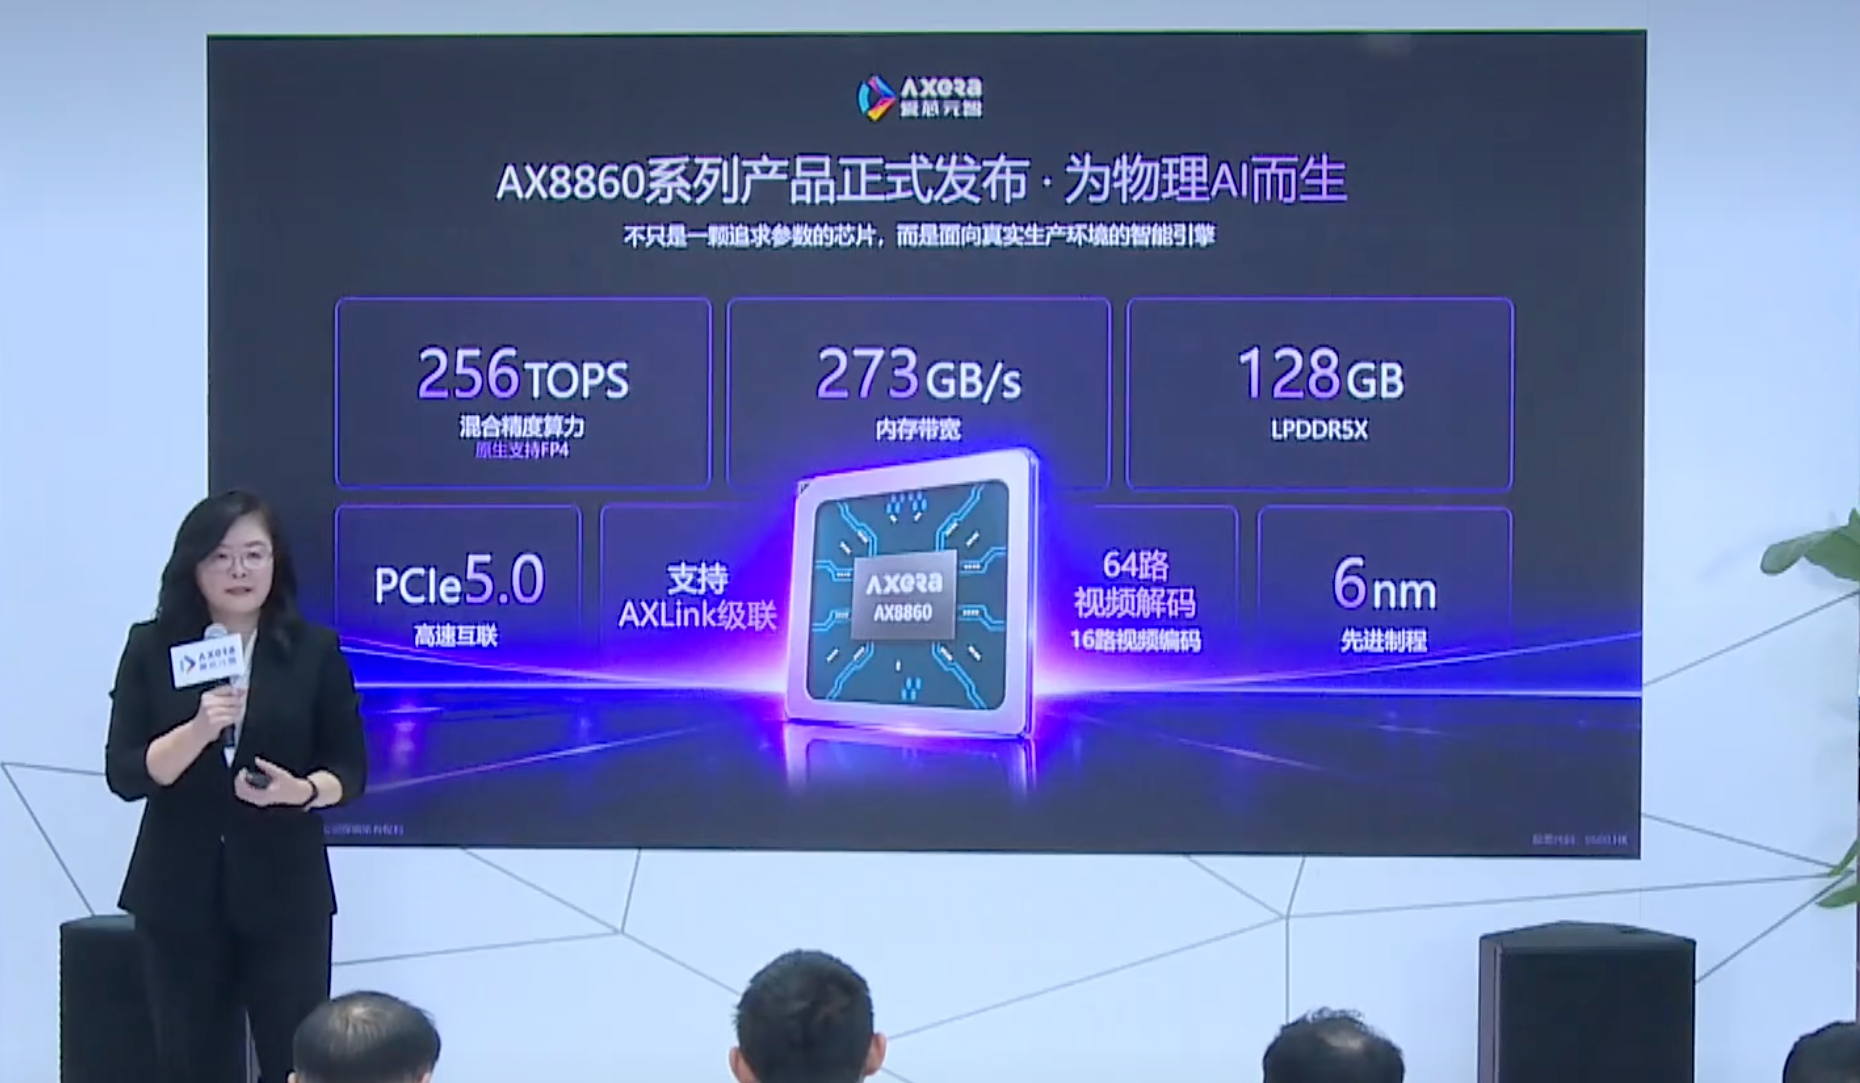
内存配置同样关键。AX8860内置273GB/s内存带宽,与国际领先GPU芯片带宽持平。爱芯元智经过调研认为,这一带宽与256T算力匹配度很高。单芯片原生支持128GB LPDDR5X内存容量,让支持的模型参数量上升一个数量级,可覆盖几百亿参数模型。
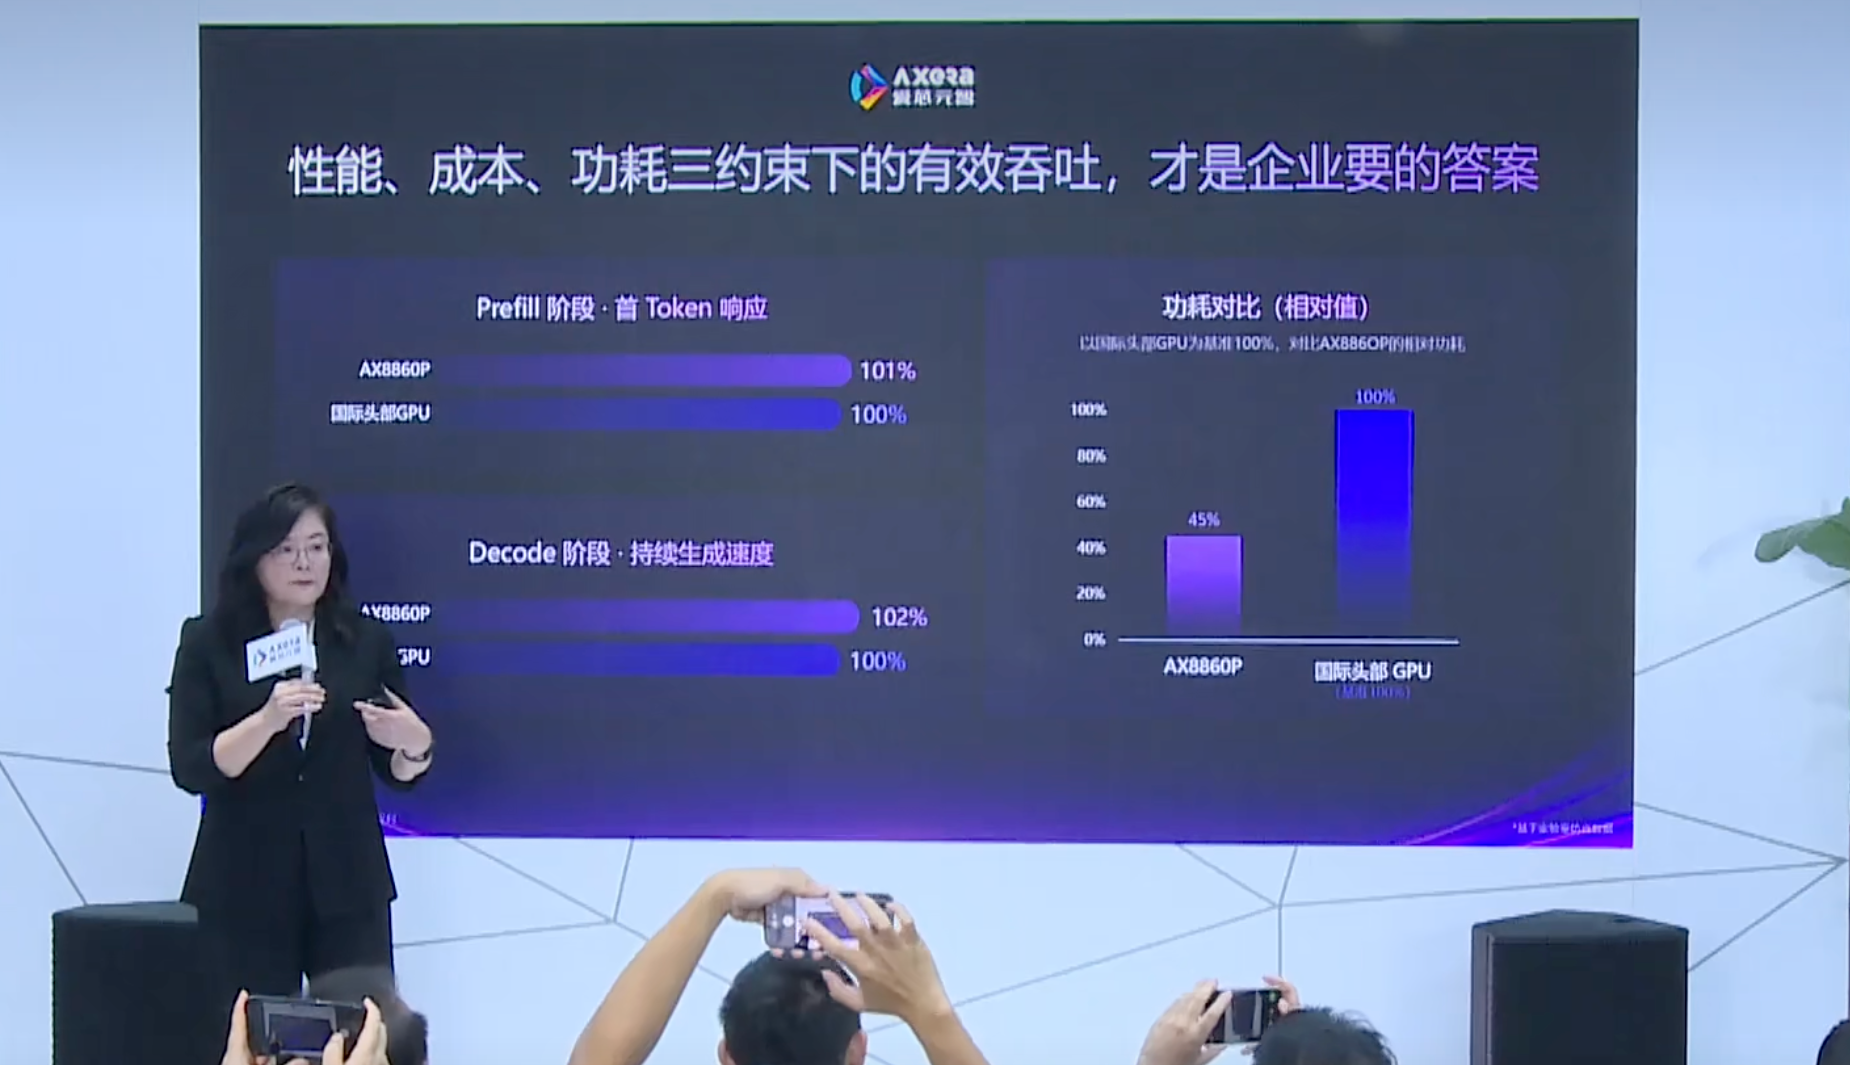
与此同时,AX8860系列采用6nm制程,重点强调功耗控制。根据爱芯元智在发布会上的介绍,在所有核心满负载运行的测试条件下,AX8860P的功耗约为其对比的国际领先GPU产品的45%。
仇肖莘在采访中提到,这一对比是芯片最大功耗,也就是将全部核心跑满或接近100%负载下的对比。实际业务运行场景中,芯片并不会持续工作在最高功耗水平。
她同时提到,国际领先厂商的平台采用GPGPU架构,其边缘侧芯片沿用了云端同源架构,因此整体功耗水平相对更高。而爱芯元智的AX8860刚回片不久,目前已完成基础Bring-Up调试,性能优化仍在持续推进。即便处于这一阶段,芯片性能已经与国际头部平台基本持平。
除了单芯性能,AX8860系列还支持通过AXLink接口进行双芯或四芯级联,并实现内存池化。爱芯元智采用AXLink互联技术,可以高效的聚合芯片算力和内存带宽。
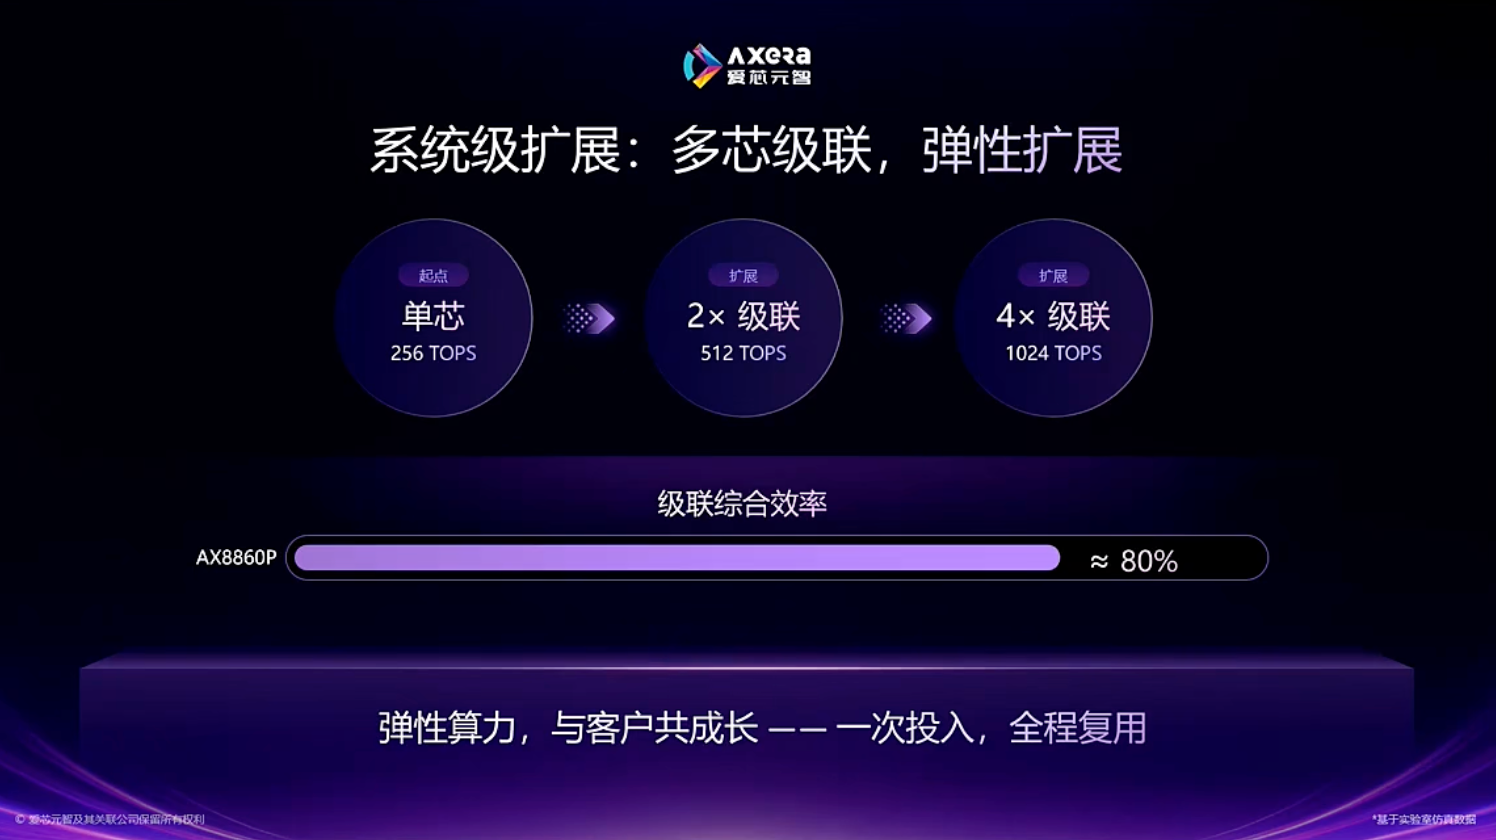
其单芯支持128GB,四芯可支持512GB内存容量。这一容量能支持千亿参数以上大模型,包括DeepSeek-V4-Flash等2840亿参数的开源模型。据悉,爱芯元智多芯级联效率维持在80%左右,高于业内平均水平。芯片还支持PCIe 5.0接口,可以用于和HOST主控的高速数据传输,也可以外扩各种接口设备,为系统集成提供扩展能力。
在推理性能的关键环节,仇肖莘在采访中指出,Prefill阶段主要依靠算力,Decode阶段则取决于带宽。对比竞品来看,AX8860P在带宽方面具备明显优势。
算力水平方面,既要关注峰值算力,还要关注架构效率,仇肖莘在采访中提到,采用GPGPU架构时,其计算单元利用率大致维持在30%-40%。而爱芯元智面向大模型设计的架构,算力利用率基本可以达到80%,同等峰值算力条件下,Prefill阶段性能能够实现2倍提升。
从单芯计算、内存配置到多芯级联,AX8860系列所强调的核心方向已经比较明确:边缘AI需要更高的算力,也需要把算力有效转化为推理性能,并在功耗、空间和成本之间找到可行的平衡。
三、从单芯到芯片家族:全算力覆盖,平台化路线满足碎片化需求
自2019年创立以来,爱芯元智在边缘计算深耕,构建了从零点几T算力到接近千T算力的完整AI芯片谱系,覆盖8910、8850、8950、8970等产品。公司定位为行业提供算力底座,客户需求千差万别,产品矩阵就要布全,不管需要什么算力基座,都有对应产品满足应用。
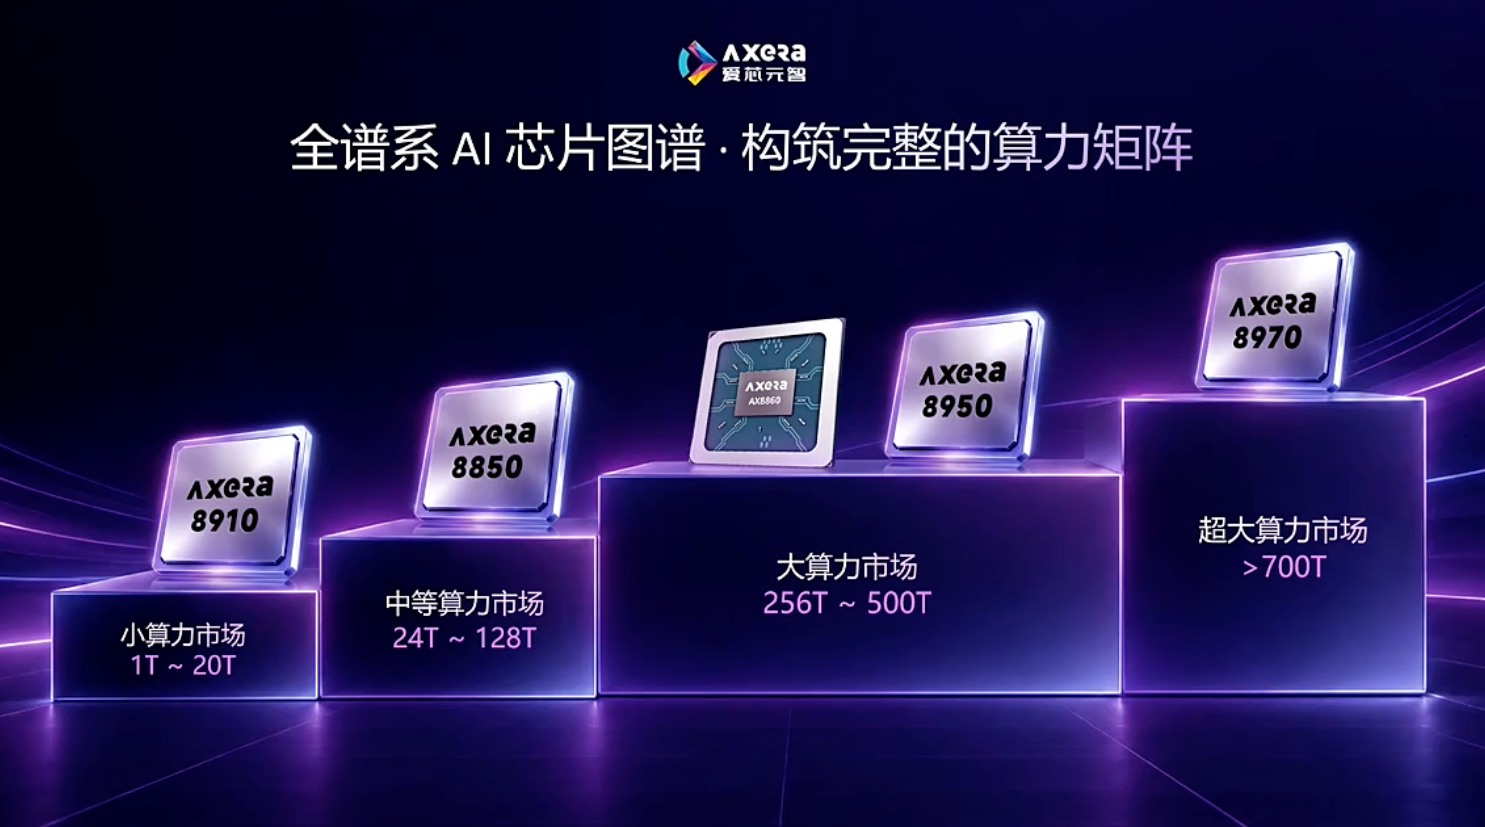
仇肖莘在采访中明确,爱芯元智的布局是边缘计算和终端计算两大业务并行。随着AX8860系列发布,全算力覆盖的产品矩阵,能够满足不同客户的碎片化需求。
在硬件形态上,A256S核心模组集成AX8860芯片及四颗LPDDR5内存,客户可以围绕核心模组设计自己的主板,减少部分底层硬件开发工作。
PCIe推理卡则面向不同的部署需求。半高半长推理卡支持单芯或双芯配置,四芯全高全长卡则可以提供更大的算力与512GB内存池。爱芯元智还展示了四卡或八卡一体机方案,进一步拓展大模型推理的部署形态。
另一款产品是Agentic Box,也就是智能体盒子。爱芯元智展示的设备采用紧凑型设计,其中一种形态兼具类似笔记本电脑电源适配器的外观,并内置AX8860核心板,可面向家庭或办公环境。
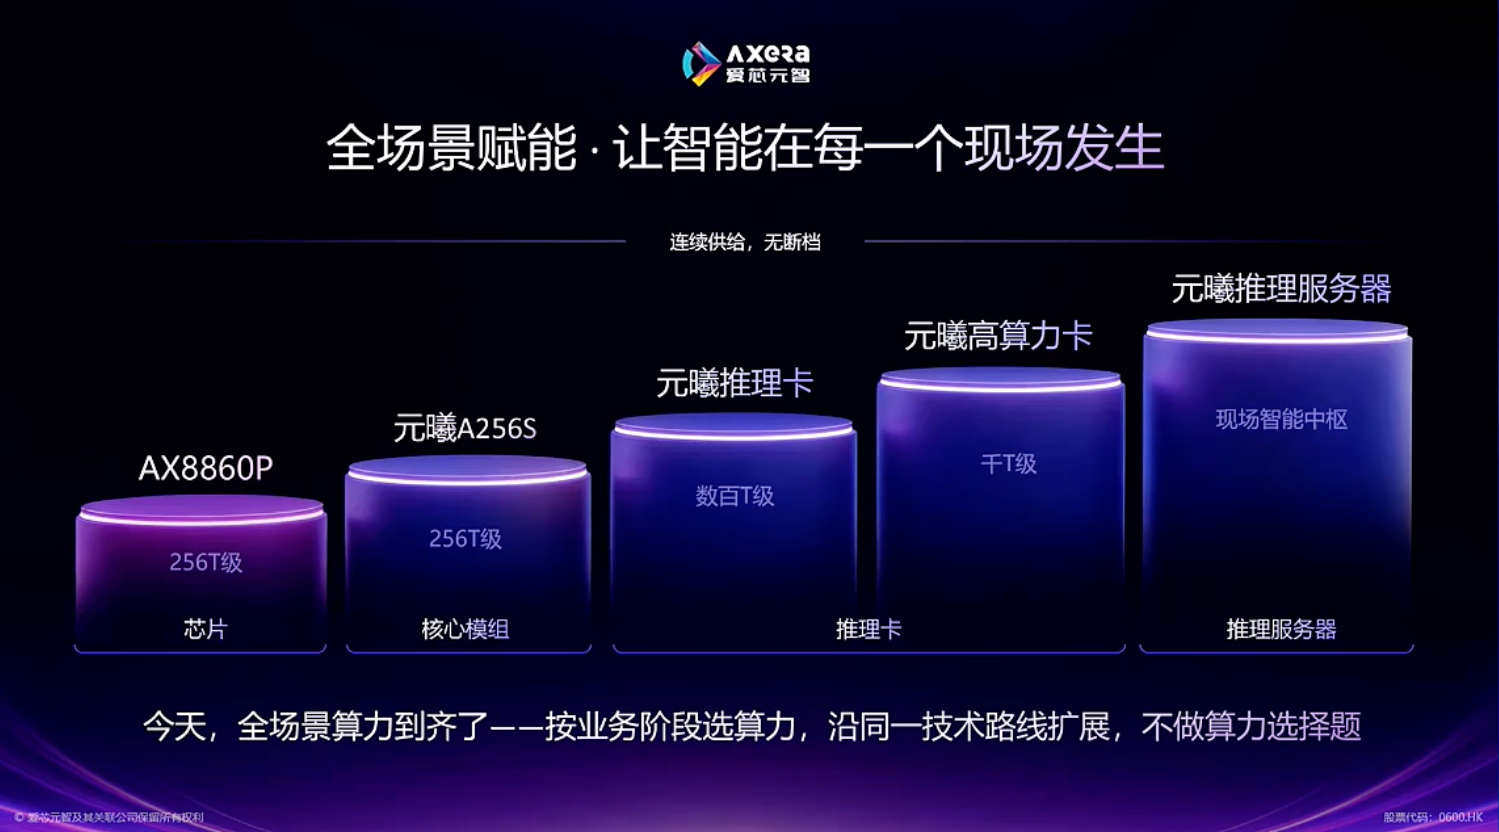
从芯片到模组,再到推理卡和智能体盒子,爱芯元智产品思路清晰:全算力覆盖,不同客户匹配不同方案,要什么拿到什么。
诚然,当下行业部分人对边端AI的认知有时偏窄,容易把边缘等同于车载。实际上,边缘和端侧是非常广泛的市场,覆盖工业设备、机器人、智能终端、企业本地部署、家庭智能体等。仇肖莘在采访中坦言,边缘领域如果仅深耕单一赛道,企业成长天花板会非常受限。
因此爱芯元智选择走平台型公司路线:首先切入视频数据采集市场;随后进入智能驾驶赛道;从去年起,拓展至边缘AI推理芯片领域。目前已有三条产品线实现规模化量产,同时这些产品线也在为面向前沿的机器人等领域的产品做技术储备。最终让边端智能像水电一样触手可得,赋能千行百业。
四、生态做厚,落地做宽:让不同客户拿到匹配的算力方案
芯片能不能落地,硬件只算一半,另一半取决于工具链是否好用、生态是否开放。
爱芯元智在工具链上投入多年,经过各种量产折磨,也向合作伙伴开放。8860的工具链进一步升级,兼容vLLM、SGLang、PyTorch等主流推理框架,支持ONNX、Hugging Face等模型格式。主流模型在AX8860上的部署,过程直接简便。
开发门槛也压得很低。其接口兼容OpenAI API,支持一行代码切换后端。客户手里现成的模型,迁移部署是一条直路。爱芯元智还提供量化、编译、Profiling、Debugging等完整工具链功能,形成算法落地的完整解决方案。
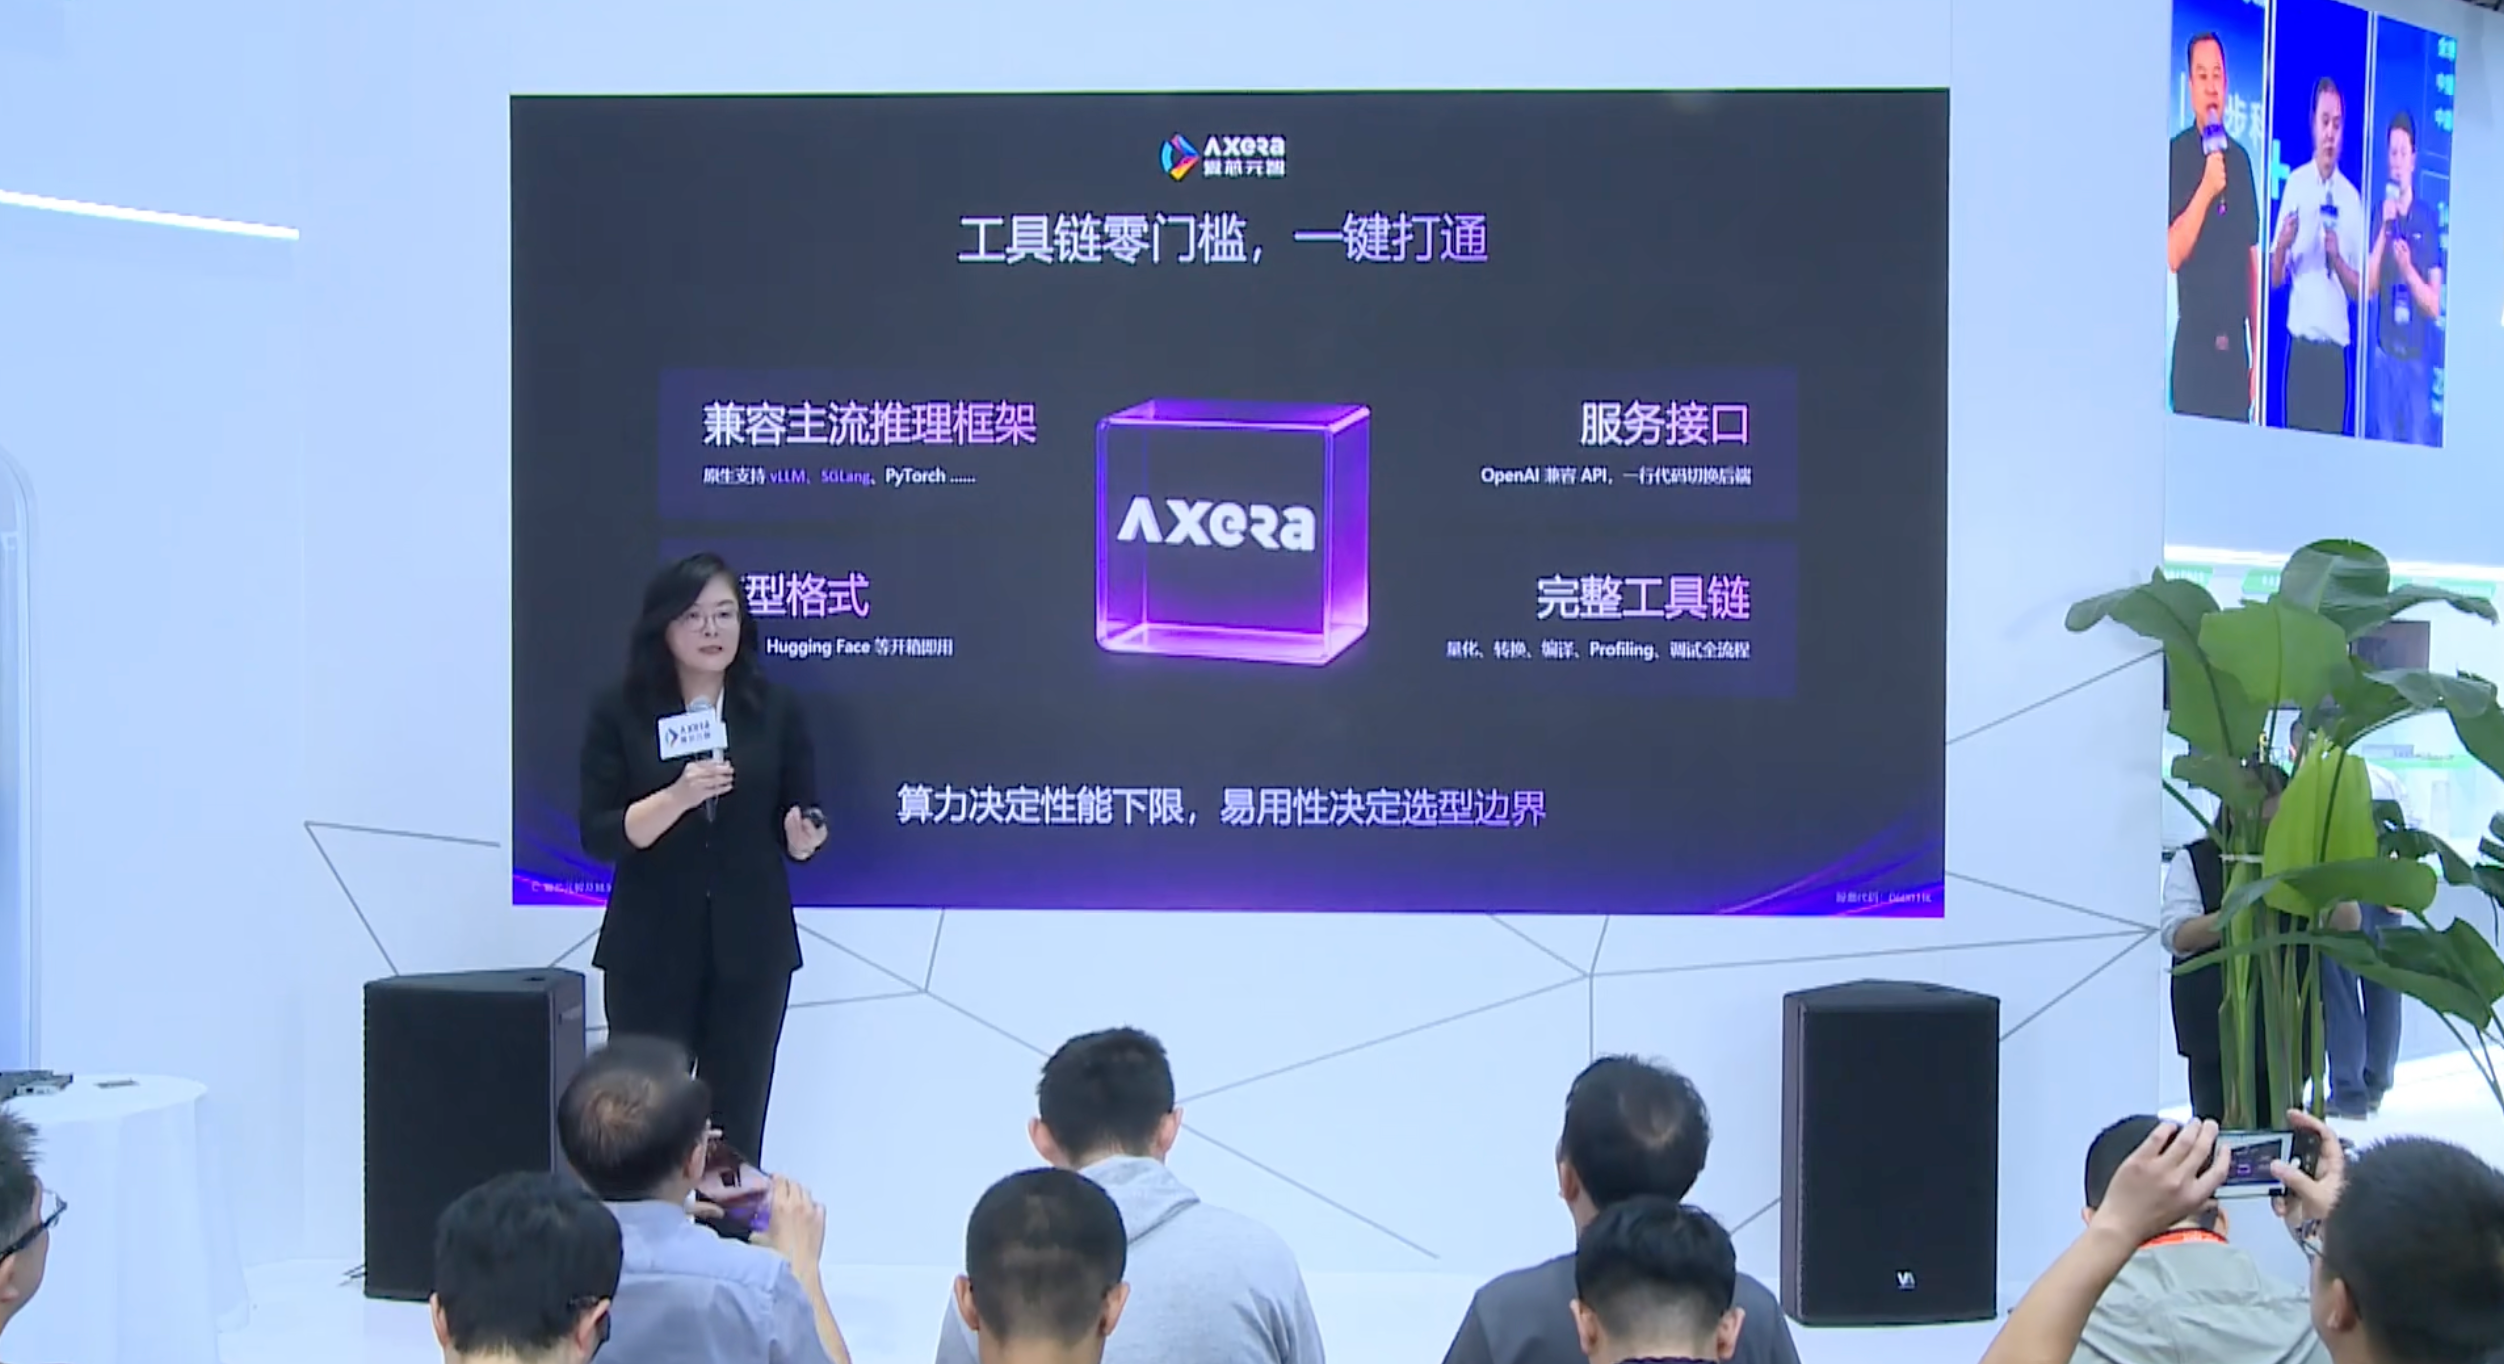
这些能力未必像峰值算力那样容易成为发布会上的焦点,却直接影响客户能否把芯片能力转化为产品。
软件生态之外,爱芯元智也强调开放合作。
仇肖莘在采访中把公司的生态定位概括为“Tier2中立生态、边界清晰”。她解释,爱芯元智对自身业务边界做了明确界定:只专注芯片研发,不涉足上层算法开发。
这样一来,算法厂商可以安心合作,不用担心爱芯元智未来切入算法业务、与其形成竞争。这在生态协作中非常关键。如果选择做垂直整合,合作伙伴的数量就会大幅缩减。公司坚持聚焦芯片主业,由合作伙伴基于芯片开发各类解决方案,同时在合作当中保持不站队的中立定位。
目前,爱芯元智已将算力产品落地多个领域,并形成了车载、终端、边缘三条代表性业务线。值得一提的是,三条业务线基于同一套原生NPU技术栈。对于客户而言,这意味着可以根据不同产品的算力需求和应用条件选择方案,不必完全受限于某一条业务线的产品定位。
这种布局也让爱芯元智的边缘计算业务拥有更大的延展空间。边缘计算并非某一种固定设备或某一个行业的专属市场,而是覆盖工业设备、智能终端及其他现场系统的一类计算方式。
结语:让智能回到事情发生的地方
AI正在从屏幕走向设备,从生成内容走向参与真实任务,这需要智能以合适的成本、足够快的速度和稳定的方式进入现场。
爱芯元智此次发布AX8860系列,并同步展示模组、推理卡和Agentic Box等硬件形态,正是围绕这一方向展开的尝试。其后续表现仍需要更多真实场景检验,但边缘计算的产业逻辑已经越来越清晰:当智能开始参与物理世界的运行,算力也需要抵达事情发生的地方。
让AI在现场感知,在现场判断,在现场执行。物理AI的下一步,正在等待这样的算力底座。
— Originally published at m.zhidx.com
Want this in your inbox every morning?
Daily brief at your local 8am — bilingual EN/中文, free.
More from WebSearch (Tavily)
See more →全球AI芯片峰会,9月上海见!
The 2026 Global AI Chip Summit will take place in Shanghai on September 22-23, focusing on the evolving AI chip landscape, including the shift from training to inference, the rise of diverse chip technologies, and the restructuring of industry competition. Notable speakers include experts from leading universities and companies, discussing advancements in AI chip architecture and applications.