AI芯片定制化浪潮下内存架构创新与接口底座的机会 | 奎芯科技联合创始人王晓阳@GACS 2026 - 智东西
Quick Answer
At the 2026 Global AI Chip Summit, Kuixin Technology's co-founder Wang Xiaoyang emphasized the shift towards customized AI chip designs, highlighting trends in memory architecture innovation, particularly the rise of HBM Base Die customization and HBF tiered storage.
Quick Take
He noted that future AI chips may adopt a hybrid architecture combining NAND Flash and HBM to optimize performance and cost.
Key Points
- AI chip design is moving towards customization and heterogeneity, creating new opportunities for memory architecture.
- HBM memory is evolving into a small subsystem requiring deep customization for different workloads.
- Future AI chips may utilize a hybrid architecture of NAND Flash (HBF) and HBM for efficiency.
- Memory is becoming a bottleneck in AI performance, with HBM costs exceeding 60% in major AI chips.
- Unified interfaces like UCIe are essential for the future of memory interconnects and customization.
📖 Reader Mode
~4 min read
9月20日,在智猩猩联合主办的 2026 全球 AI 芯片峰会开幕式上,奎芯科技联合创始人兼副总裁王晓阳分享了《AI芯片定制化浪潮下内存架构创新与接口底座的机会》主题演讲。
在王晓阳看来,AI 芯片设计逐渐走向定制化、异构化、专用化,给内存架构创新带来新机会,HBM Base Die 定制化和 HBF 分层存储成为新趋势。
HBM 内存正在从标准单品发展成小型子系统,需针对不同工作负载深度定制。HBF 采用 NAND Flash 定制化堆叠,带宽接近 HBM,容量则高一个数量级。未来 AI 芯片可能采用 NAND Flash(HBF)+HBM 混合架构,将 KV Cache、Attention 等延迟敏感数据留 HBM,可预测的专家权重卸到 HBF。
奎芯科技拥有全栈内存与接口 IP,在 UCIe,HBM,LPDDR,ONFI/NAND 等接口方面积累深厚,能够为定制内存+标准互联架构提供接口底座技术。目前奎芯标准封装 32G M2 UCIe 接口 IP 已完成硅验证,其打造的 Chiplet 产品 ML100 IO Die 能实现 HBM 与 xPU 解耦,已流片交付客户。
以下是演讲整理:
王晓阳:各位朋友上午好,感谢主办方邀请。AI 芯片的设计已经逐渐走向定制化、深度异构化和专用化。传统那种”大的单颗标品”,很难解决现在的计算效率问题。我想分享的是,在这个浪潮下,内存的架构创新也有一些新的机会,以及我们如何在这个机会下做一些创新。
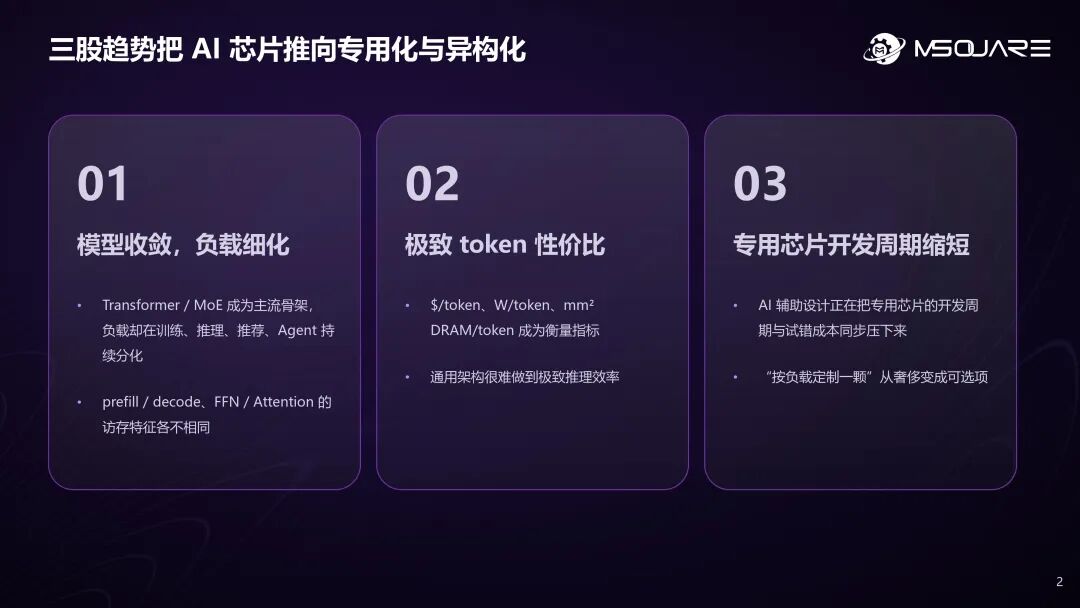
当今 AI 的发展有三股趋势,把 AI 芯片推向更深度的异构和专用化。
(1)模型收敛,负载细化。Transformer 已从最早的 LLM 走向视觉、端侧和具身智能等各个领域。同时训练和推理开始分离,推理中把 prefill 和 decoding 用硬件分离计算来提高效率;再深入 decoding 内部,Attention 和 FFN 也在分离,两者对访存的密集度和计算的密集度不同,用专用硬件做专用的事情能提高效率。
(2)极致 token 性价比。从 $/token 到 W/token,再到 mm² DRAM/token,归根结底都是成本问题:如何用更低的成本产生更多更有效率的 token。
(3)专用芯片开发周期缩短。尤其在 AI 辅助设计加持下,专用化、异构化芯片的开发成本和周期在降低和缩短。
从这三个趋势来看,AI 芯片已经从最开始的标品变得更加专用和异构。
二、内存成为AI系统瓶颈 HBM内存正在发展为小型子系统
说到 AI 计算就不得不说内存,今年 Hot Chips 上讨论热度也很高。这是因为内存已成为 AI 性能和成本的瓶颈。

带宽墙和容量墙是核心问题。算力每代增长约三倍,HBM 带宽增长不到两倍,剪刀差持续扩大;模型参数已达到 trillion 级别,Kimi K3、V4 Pro 都是如此。
如今增加更多卡、更多芯片,很多时候不是为了提升算力,而是为了放下模型。NVIDIA、AMD、Google、Amazon 四家的 AI 芯片中,HBM 已占物料成本的 60% 以上(2025 年 Q4 约 63%),超过一半费用流向内存厂商。

虽然 HBM2E 到 HBM4E 带宽提升了数倍,但标品持续升级的代价越来越高。
堆叠层数从 8 层到 16 层甚至更高,技术难度不断增加;由于带宽需求提升,传统 DRAM 工艺已难以支撑 Base Die,内存厂商开始将 Base Die 转向先进逻辑工艺。同时,DRAM 晶圆投入持续增加,同容量下 HBM 消耗的硅面积是 DDR5 的约三倍,到 HBM5 功耗密度可能提升四倍。成本、功耗和技术难度都在上升。
因此,内存厂商开始探索定制化设计。既然采用了先进工艺,是否可以在内存中加入更多能力,让内存变得更加高效、更加智能?

三星正在推进 cHBM:C-die(Core-die) 堆叠保持标准,B-die(Base Die)单独定制,Base Die 采用 4nm 逻辑工艺,并用 D2D 接口替代传统 HBM PHY,同时下沉部分控制、遥测和 RAS 功能。SK hynix 从 HBM4 起将 Base Die 交由台积电先进逻辑工艺制造。NVIDIA 则推出 NVHBM,将内存控制器和定制PHY搬进 Base Die,对外通过以授权方式开放的 NVLink Fusion 接口接入。整体来看,未来 HBM 定制化趋势将基于标准 D2D 接口展开。
我们认为,Memory 未来可能会从标准单品逐渐发展成一个小型系统,需要存储厂商、代工厂商、AI 芯片公司和先进封装厂商共同合作,每一个 HBM 都可能针对不同负载进行深度定制和优化。
三、未来AI芯片的内存可能采用HBF+HBM混合架构

传统 HBM 本身也存在瓶颈,尤其是容量问题。目前单堆栈容量约 48GB,难以装下 MoE 大模型的专家权重。
其次,HBM 也存在“大材小用”的情况。大模型权重访问通常是只读、顺序、可预测的,用不上它昂贵的随机带宽和硅面积。
同时,很多适合 HBM 的负载,也可以 offload 到更便宜的存储上。内存的 hierarchy,从最上层最贵、最小、最快的 SRAM,到中间的 DRAM,再到 SSD,中间其实可以加一层 HBF:利用 NAND flash 做定制化,通过多层堆叠获得接近 HBM 的带宽,同时容量提升一个数量级,用更低成本存储 AI 参数。

现在 AI 数据已经呈现分层特征。以 Kimi K3 为例,约 1.56TB 权重中有 93% 是专家池;而大模型总参数与每个 token 激活参数之间相差约 47 倍。这意味着部分场景下,可以考虑将模型参数存入 NAND flash,降低对 HBM 的依赖。例如小 batch、TPOT 要求不高的场景,容量可能比带宽更重要。
对于大稀疏 MoE 模型,专家池具有只读、顺序访问,甚至可预测等特点,更适合用 NAND flash 存储。而 KV cache、attention 增量数据等需要随机读写、低延迟的数据,仍需要 HBM。
因此,未来 AI 芯片的内存可能采用混合架构:一部分使用 NAND flash 的 HBF,一部分使用 HBM,以兼顾效率和成本。
四、内存定制深化需要接口统一UCIe生态下内存互联新形态
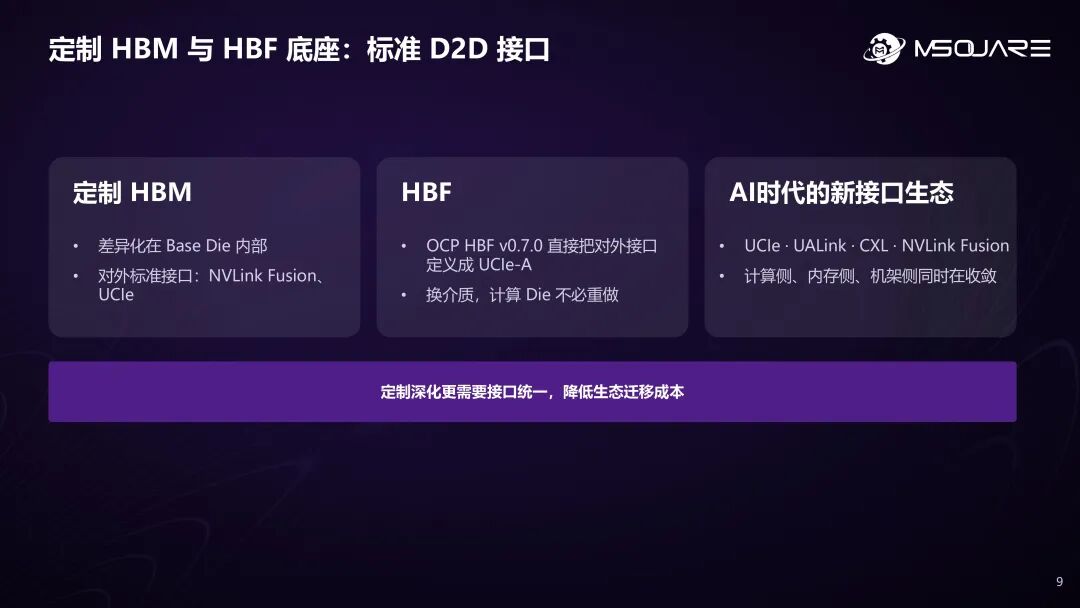
无论是内存厂商推进的定制化 HBM,还是 HBF,目前底层接口都趋向标准化,采用 D2D 接口或标准 UCIe 接口作为连接。
除了接口标准化,内部逻辑部分仍可以针对不同负载进行定制。HBF 新标准 OCP HBF v0.7 已将 UCIe-A 定义为标准接口。未来芯片公司可以在统一接口下更换不同介质,降低开发成本和周期。
新 AI 计算时代,接口生态正在逐渐收敛:封装内及跨封装可采用 UCIe 及其衍生接口;scale-up 域 UALink 逐渐成熟;CXL 成为 memory pooling 的事实标准;NVLink Fusion 则以授权方式向定制 ASIC 开放,但仍由 NVIDIA 主导。
因此,无论计算侧、内存侧还是机架侧,都在向标准接口收敛。在深化定制的同时,统一接口可以降低生态迁移成本。

未来 xPU 计算若采用统一互联接口,如 UCIe,外部可灵活替换不同存储、计算和内存介质,大幅降低开发成本。例如通过 IO Die 或带 UCIe 接口的 Base Die:IO Die 可以连接标准 HBM、LPDDR,Base Die 也可以堆叠定制化 DRAM 或 NAND flash。不同介质通过统一接口实现生态兼容。
目前这类生态我们都在探索,部分已经向客户交付。
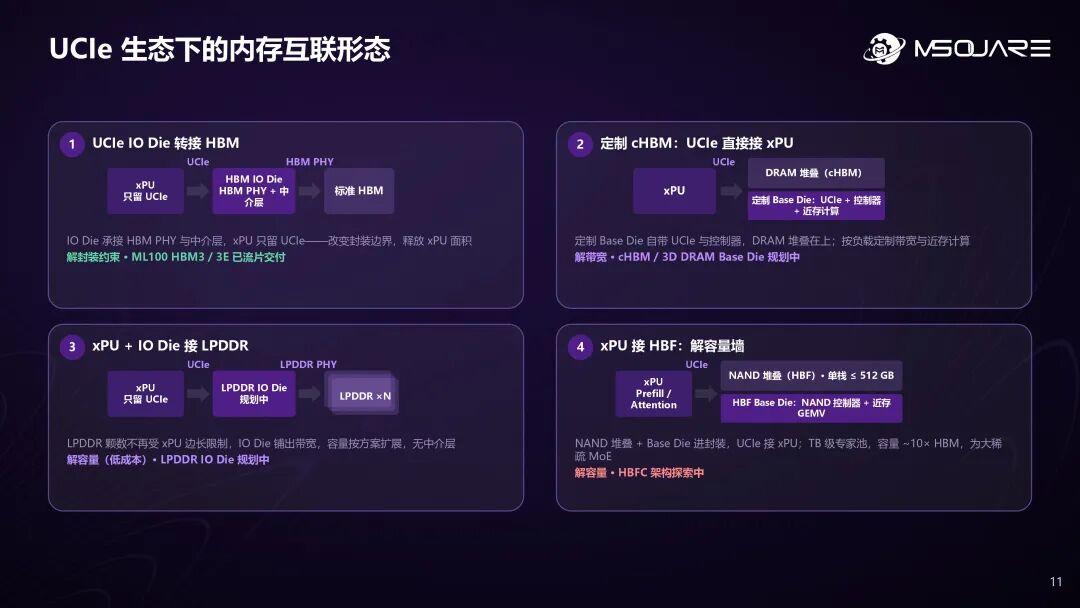
(1)xPU 通过 UCIe 连接自研 IO Die,外接标准 HBM,已经实现客户交付;
(2)将 HBM 替换为 LPDDR,LPDDR 颗数不再受 xPU 边长限制,由 IO Die 扩展带宽,容量可按方案扩展,且无需中介层(LPDDR IO Die 研发中);
(3)在 UCIe Base Die 上堆 DRAM,则可以实现定制化 DRAM,并进一步支持控制器下放、近存计算等能力(规划中);
(4)将颗粒替换为 NAND flash,则形成 HBF(架构探索中)。
通过 xPU 绑定 UCIe 生态,可以灵活实现不同内存形态。
五、奎芯探索第四种角色公司内存接口IP全景
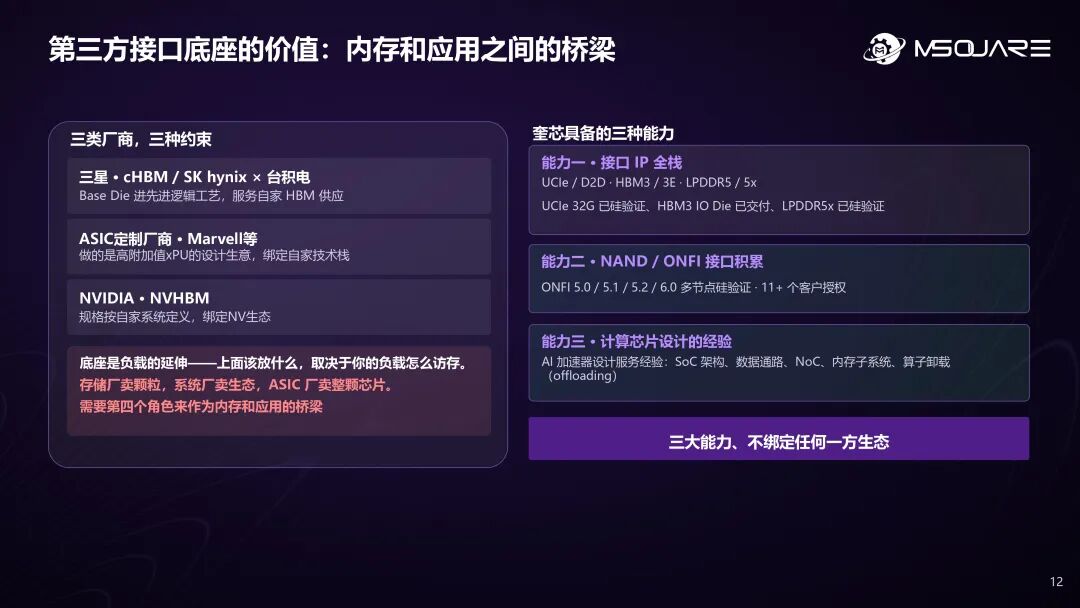
目前,内存产业中,存储厂商提供存储颗粒,系统厂商构建生态,ASIC 厂商提供定制芯片。但未来可能还需要第四种角色,连接内存厂商与应用需求,因为做内存和做计算的思维并不相同。
奎芯的核心探索就是成为这样的桥梁,同时具备接口 IP 全栈、NAND/ONFI 接口积累、计算芯片设计的经验三种能力。我们完全可以在不绑定任何一种生态的情况下承接第四种角色。
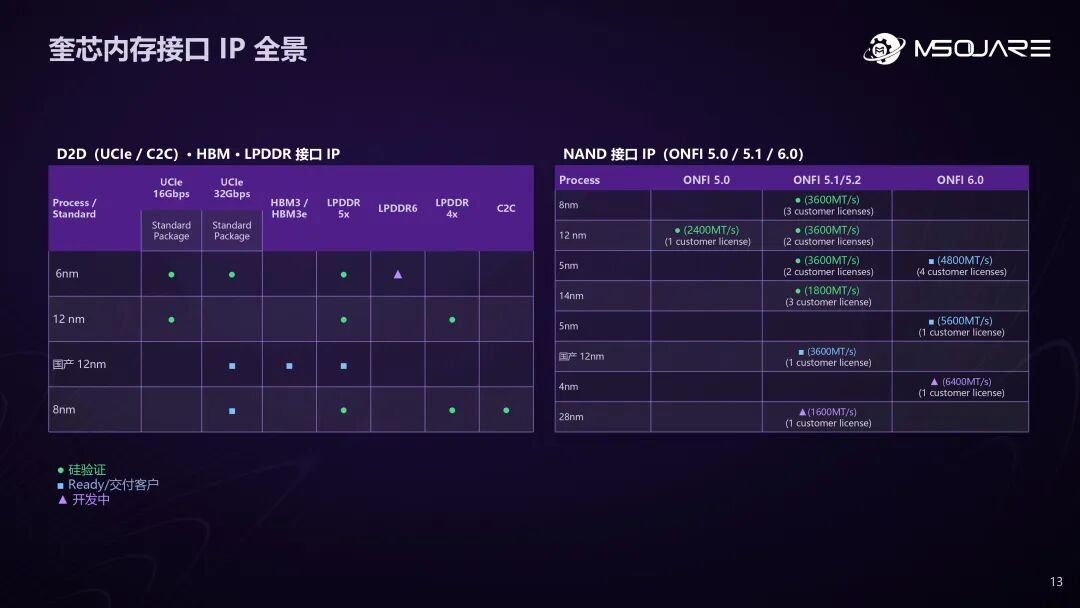
简单介绍一下我们的全栈 IP 能力。上图左边包括 UCIe 等内存接口:UCIe 16G 已量产,32G 已完成硅验证;HBM3 和 HBM3E 已在国产工艺上交付客户;LPDDR5X 已完成多工艺硅验证,LPDDR6 IP 正在开发中;芯片间互联也有自研 C2C 接口。
NAND flash 部分,从 ONFI 5.0 到 6.0,已完成多个速度、多个工艺节点的硅验证与交付,累计超过 25 个商业化项目。
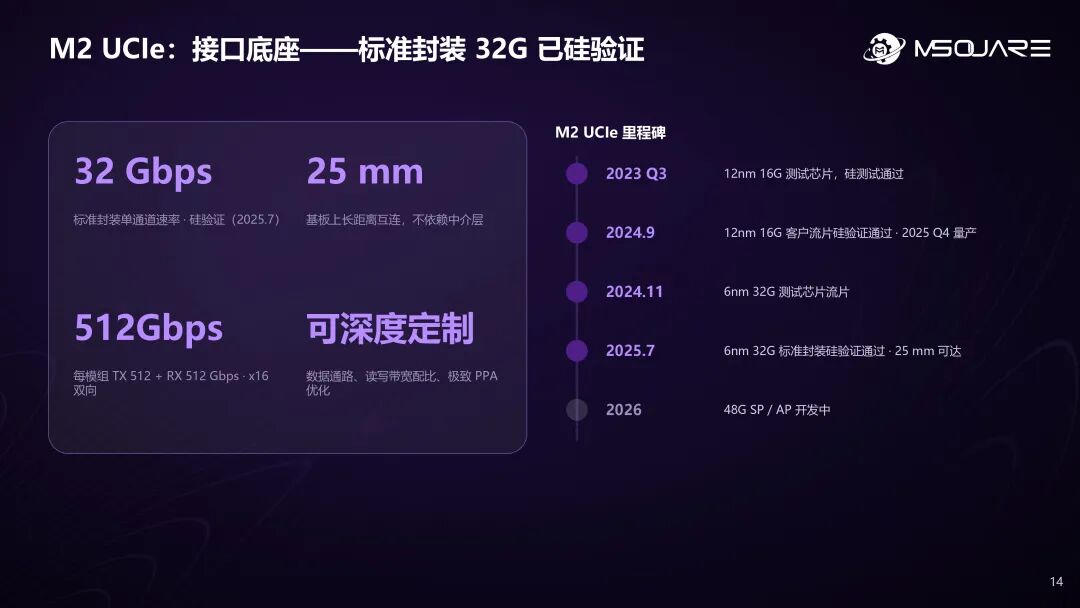
UCIe 可能会成为最普遍的片间互联协议。奎芯目前开发的 M2 UCIe 32G,在标准封装中实现,而非先进封装,满足国内 AI 芯片客户需求。可实现 25 毫米长距离互联,不依赖硅中介层,每模组收、发带宽各达 512Gbps,同时支持深度定制。
由于不同场景对 die-to-die 接口有不同需求,标准 UCIe 可能无法满足极致能效需求。因此,从 2023 年开始,我们持续开发多工艺、多速度、多规格 UCIe 产品,下一代 48G 产品也在推进。
UCIe 架构上,我们提供从 PHY、adapter 到 protocol 层的全栈解决方案。每代 UCIe 都会进行多 die 合封测试,验证不同距离下 die-to-die 互联性能和可靠性。
基于 UCIe 生态,我们也打造了 Chiplet 产品——ML100 IO Die,已流片并交付客户。

ML100 IO Die 可以实现 HBM 与 xPU 解耦。这种方式可以降低 HBM 热效应对 SoC 的影响,减少 SoC 内 HBM PHY 面积,让距离和连接方式更加灵活;同时中介层只需覆盖 HBM 与 IO Die,面积大幅缩小,降低封装成本和供应链压力。未来通过 UCIe 标准接口,也能连接不同规格外部介质,实现更灵活、更低成本的产品形态。
六、总结:定制内存时代,需要新接口和底座
综上,我们认为未来不仅需要更大、更快的内存形态,而且需要把不同内存按负载和数据去分层,从而更高效利用这些内存。因为内存本身未来会持续是紧缺、或者说比较昂贵的产品。

- 模型架构也在为这个事情做持续的优化。
- AI 芯片本身和内存本身也都在做系统级定制化。内存未来也会成为一个小小的子系统,不仅是一个标品。
- 这些事情最终也需要我们 AI 芯片设计公司在软件层面对软件和生态去适配。
所以从这三个路径讲,未来需要让不同数据存到不同地方,从而更高效利用现有所有计算资源。
在定制内存时代,我们需要新接口和底座来打造系统。奎芯做的就是基于现在标准 UCIe 接口及生态,在这个生态之上打造一些适合的内存基座,用这种方式来加速、来赋能我们 AI 计算生态。
谢谢大家。
— Originally published at m.zhidx.com
Want this in your inbox every morning?
Daily brief at your local 8am — bilingual EN/中文, free.
More from WebSearch (Tavily)
See more →全球AI芯片峰会,9月上海见!
The 2026 Global AI Chip Summit will take place in Shanghai on September 22-23, focusing on the evolving AI chip landscape, including the shift from training to inference, the rise of diverse chip technologies, and the restructuring of industry competition. Notable speakers include experts from leading universities and companies, discussing advancements in AI chip architecture and applications.