BestBlogs 早报|Google 算力负责人谈有效产出
Quick Answer
Google's AI infrastructure chief Amin Vahdat emphasizes the importance of Goodput over theoretical FLOPS for effective AI output, highlighting the need for reliability and recovery costs in performance metrics.
Quick Take
GitHub is revamping its Git infrastructure to handle increased developer and AI agent workloads, while economist Daron Acemoglu warns that automation must be paired with investment and organizational change to truly enhance value.
Key Points
- Amin Vahdat stresses Goodput for AI performance, integrating reliability and recovery costs.
- GitHub's push operations increased by 4.9x, necessitating infrastructure overhaul.
- Acemoglu highlights the need for investment alongside automation to create value.
- Google aims to double effective token service capacity every six months.
- AI agents must adapt to continuous workloads, affecting system design and resource allocation.
DeepSignal Analysis
What happened
Amin Vahdat, Google's AI infrastructure chief, highlighted the significance of Goodput over theoretical FLOPS for AI performance. GitHub is restructuring its Git infrastructure to manage increased workloads from developers and AI agents. Economist Daron Acemoglu emphasized that automation requires investment and organizational changes to enhance value.
Key evidence
- Amin Vahdat stated that effective output in AI systems should account for reliability and recovery costs, rather than just theoretical FLOPS.
- GitHub reported a 4.9-fold increase in monthly push operations, indicating a significant rise in developer and AI agent activity.
- Daron Acemoglu warned that without proper investment and organizational adjustments, the potential benefits of automation may not be realized.
Why it matters
The focus on Goodput reflects a shift in how AI performance is evaluated, emphasizing real-world reliability over theoretical metrics. GitHub's infrastructure changes indicate a response to the growing demands of AI and developer collaboration. Acemoglu's insights highlight the need for a holistic approach to automation, suggesting that mere technological advancement is insufficient for maximizing value.
📖 Reader Mode
~6 min readBestBlogs.dev 是 AI 驱动的私人阅读助手。这是面向所有人的每日早报内容,如果你希望它基于你的兴趣和阅读习惯整理,可以体验「我的早报」。
导语
一个智能体在代码仓库里连续工作,消耗的远不止模型调用:它还会保存进展、拉取代码、执行测试,把新的变更送进合并流程。Google 和 GitHub 的一手分享让这些平时藏在后台的工作变得清楚:模型能持续执行之后,整个系统也要能够持续承接。
企业内部还有另一种变化需要理解。诺奖经济学家 Daron Acemoglu 在访谈中讨论,技术能够自动化多少任务,与组织最终能创造多少价值之间,隔着数据、配套投资和人的经验。三篇内容分别提供算力、交付与工作选择的判断尺度;后面的实践则把这些判断落到本地检索、模型路由、结果验证和权限管理。
★ 精讲一:Google AI 基础设施负责人 Amin Vahdat:前沿 AI 的物理与经济约束
来源:Sequoia Capital · BestBlogs 评分:91

Amin Vahdat 在红杉的访谈中,将 AI 数据中心的表现落到 有效产出 上。理论 FLOPS 告诉我们芯片在某些条件下能计算多快,真实任务却由加速器、CPU、网络、存储和软件共同完成。同步负载中的一个组件失效,可能拖停整个计算;检测故障、恢复检查点、重新执行的时间,都要算进交付结果。在这些时刻,设备依然做了工作,但尚未推进用户要得到的答案。用 Goodput 衡量系统,意味着把可靠性和恢复成本一并纳入性能,而不是只挑选正常运行时的漂亮数字。Vahdat 强调,团队应该对真实负载在实际故障条件下交付的结果负责,这也是从芯片指标走向系统指标的区别。
Google 大约每六个月翻倍的目标,指的是有效的 token 服务能力,并不等于同期把芯片数量翻倍。模型优化、运行时改进和硬件进步都能贡献容量;Vahdat 没有给出各项收益的精确分拆,却指出模型侧改进往往贡献很大。TPU 的演进也说明专用设计的取舍:它从推理起步,逐渐服务训练和更多负载,效率收益依赖对未来需求的判断。为某种工作负载做得越专门,就越需要确认它足够持久。因此,硬件团队必须与 DeepMind 等模型团队紧密协作,把模型变化与芯片设计周期衔接起来。数据中心的建筑、供电和冷却,同样需要和设备联合设计,不能只在机器交付以后再寻找放置空间。
持续运行的智能体,使这种联合设计更加具体。人在聊天过程中会等待、思考和输入下一条消息,智能体则能继续检索、执行工具与分析反馈,把任务循环延长。CPU 编排、网络和存储因此都要承接新的需求,而供电仍是长期的根本约束。与 10 月 5 日早报里 Crusoe 对能源和算力成本的讨论相接,这次访谈提供了更贴近系统运行的尺度:每瓦电力到底交付了多少有用工作。对构建 AI 服务的团队,这意味着先观察重要任务花在计算、等待和恢复上的时间,再决定增加硬件还是修复软件损耗。扩容的方向,可以从一条真实任务的完整执行路径中找到。
★ 精讲二:为代理规模开发构建 Git 基础架构
来源:The GitHub Blog · BestBlogs 评分:91
GitHub 正在重构 Git 基础设施,以承接开发者与智能体同时工作的负载。官方文章给出的变化有明确口径:月度 push 操作同比增长到约 4.9 倍,9 月提交数达到 73.8 亿。前者是推送操作,后者是提交数量,不能当成同一指标。智能体可以在每轮工作后保存进展,推送延迟因此会直接限制后续执行;推送又触发持续集成、代码扫描和大量 clone、fetch 请求。与此同时,分支上的工作最终要汇入共同的引用,合并仍需一致地协调。仓库面对的不是单纯更多下载,而是高频写入、共享引用更新和读取放大同时出现,系统必须让新的状态可靠保存,并及时让后续任务看到。
现有 Spokes 架构把完整仓库副本保存在多台文件服务器的本地磁盘上。副本承担持久保存和提供读取两项责任,增加副本可以分摊读请求,却也让更多节点参与每次写入。于是,读扩容与写入协调相互牵制:写操作需要等待副本集合完成工作,新增读容量可能拖慢推送;副本故障减少读容量,失去法定数量则会阻止写入。这种设计长期服务了大多数仓库,在最繁忙的仓库上却成为上限。GitHub 的新方向,是把持久保存交给 Azure Blob Storage,让请求服务层独立扩展;同时把维护移出请求路径,减少必须同步完成的工作,并行处理非关键任务。解耦的是责任,而不只是更换存储介质。
这套新架构仍在建设,GitHub 要在服务持续运行时推进迁移,并保留用户依赖的可靠性和控制能力。文章的可迁移价值,在于揭示规模变化怎样改变原有取舍:对于人类开发者很轻微的推送延迟,在智能体的紧密循环里可能变成明显瓶颈;为读负载增加的副本,也可能给写负载带来代价。昨天介绍的 ReviewBench 关心代码如何被有效审查,这篇则把视角延伸到提交和交付本身。团队运行多个编码智能体时,可以沿着提交、测试、合并的队列观察等待,识别哪一层决定交付速度。模型提高代码产出以后,交付路径上的协调和可靠性,值得成为下一轮工程投入的对象。
★ 精讲三:诺奖经济学家 Daron Acemoglu:AI 改变工作时,如何保持自身价值
来源:Silicon Valley Girl · BestBlogs 评分:91
Daron Acemoglu 在访谈中重新审视了对 AI 自动化的谨慎预测。他承认今年智能体的发展可能让可自动化任务的比例高于旧估计,同时强调技术扩散需要配套投资与组织调整。他没有给出新的确定比例。编码与客服的对照,解释了应用速度为何不同:代码通常能运行和测试,失败反馈比较清楚;客服却面对不同人的表达、不断变化的请求和大量灰区,回答听上去合理,也可能没有解决真实问题。在他看来,工具能力只是进入工作的一部分,监督、协作和流程设计都影响最终结果。这个视角把讨论从模型能做什么,推进到组织怎样让它完成一件真正有用的事。
Acemoglu 认为,美国过度关注基础模型,投入应用与劳动者协作工具的力量还不够;中国制造企业将工程人才投入生产线,提供了另一种实践路径。这是他的经济判断,不能当成对两国产出效果的统一测量。自动化可以节约成本,但如果企业只以替代员工为目标,就可能错过新任务、新产品和高生产率岗位。他因此把创业机会指向高质量数据与细分应用:行业长期积累的信息,以及一线员工掌握的隐性知识,能帮助发现难复制的需求。团队要到现场理解客户怎样表达问题、员工怎样处理例外,再把这些经验转成工具能力。应用优势来自这种理解,也来自不断改善数据与工作方法。
对个人,他强调数学、物理、经济或工程等基础,以及灵活性和独立思考。AI 可以辅助研究和处理任务,人的知识仍帮助判断问题是否值得解决、结果是否可靠、下一步应如何选择。今天 Every 的共享工作流案例,提供了一个组织层面的具体参照:个人发现的有效做法能够传播给同事,人工修改还能继续进入技能。把访谈与案例放在一起看,值得问的是,团队正在用 AI 减少既有任务的成本,还是帮助成员承担新的、有价值的工作?从一线经验、数据质量和实际应用出发,这个问题就能落到具体投入上。技术的收益,最终还需要通过人的工作和组织选择实现。
速览
来源:Google Developers Blog · BestBlogs 评分:89
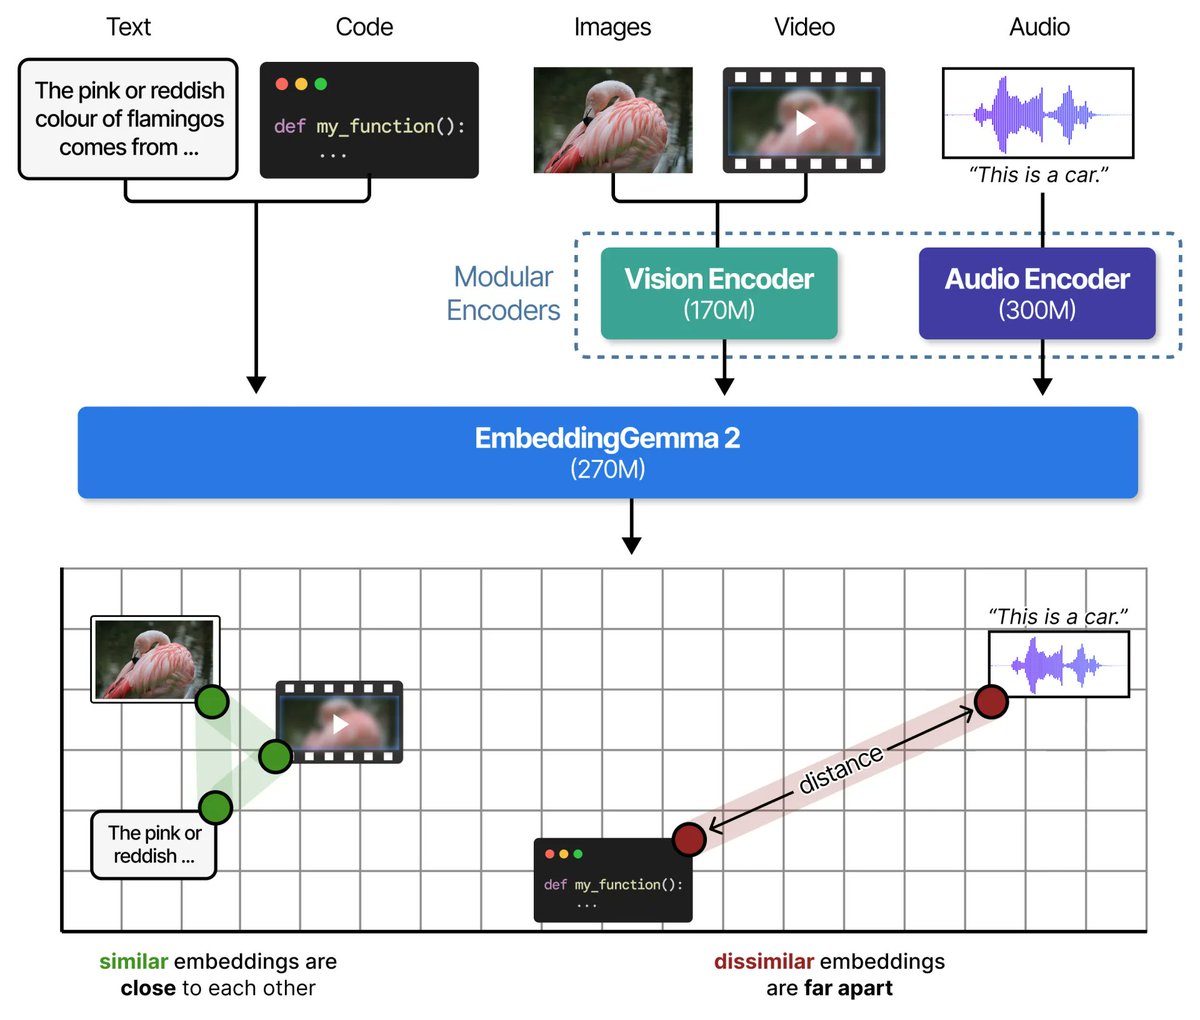
Google 的官方指南把 EmbeddingGemma 2 放进实际检索场景:它将文本、代码、图像、视频和音频映射到共享的 768 维空间,支持跨模态搜索。模型采用 Apache 2.0 许可,完整配置为 740M 参数;只加载文本和代码时为 270M,再按需要添加视觉或音频编码器。这种模块化让开发者可以依据内容类型选择运行配置,不必为没有使用的模态承担完整权重开销。
存储侧使用 Matryoshka 表示,可以把向量截到 512、256 或 128 维。指南指出,256 维时文本与代码保留大部分质量,图像、视频和语音检索约保留 95%,任务类别会影响取舍。检索查询和文档还需要不同的任务提示,使表示对齐各自角色;与 Gemma 4 配合时,共享的分词器和音频编码器架构有助于降低组合管线的内存需求。
这是一条从模型能力走向部署选择的路径。嵌入模型找出相关材料,生成模型再利用材料回答问题,两者负责不同环节。本地内容搜索、代码库索引或离线多媒体检索,可以先选必需模态,再比较不同维度下的召回表现。减少内存和存储,与保持实际检索质量,需要在自己的内容集上一起衡量;模型的小体积,为这种按场景设计提供了更灵活的起点。
如何在 Agent harness 中构建模型路由:Open SWE 的成本实验
来源:LangChain · BestBlogs 评分:88
LangChain 产品经理 Sydney 分享 Open SWE 的首轮模型路由实验:近 500 条线程中,相对始终使用高性能模型,路由组的单线程成本中位数下降 64%,P90 成本下降 37%,合并 PR 的比例未出现统计显著差异。后者是任务结果的一个代理指标,不能涵盖全部代码质量;成本数字也来自团队自己的实验,而非对所有编码任务的普遍保证。
方法从实际任务开始:先读 LangSmith 追踪,归纳请求类型和复杂度;再沿成本与能力的帕累托前沿选择快速、均衡、高性能三档,用分类器在一条线程开始时选模型。首轮分别有 34%、56%、10% 的线程进入三档。另一轮试图与始终使用快速模型比较,却因用户投诉提前停止,说明便宜模型并不适用于全部任务。中途换模型还可能让缓存失效,这也是路由策略需要考虑的成本。
这组实验提供了一个清楚的顺序:了解任务,选择少量有差别的模型,运行路由,再同时跟踪花费与完成结果。路由不是每次调用追求最低价格,而是让模型能力与任务需求匹配。对长期运行的编码服务,真实任务分布比抽象排行榜更接近决策依据;持续收集失败反馈,也能帮助识别哪些任务应该回到更强的模型。
你的 LLM 裁判可能自信地说错:Browserbase 与 Microsoft 如何构建更可靠的验证器
来源:AI Engineer · BestBlogs 评分:89
Browserbase 技术负责人 Miguel 和 Microsoft 研究员 Corby 报告,同一个浏览器智能体在现有 WebVoyager 裁判下成功率为 74%,在他们认为更贴近人工标注的验证器下约为 38%。这组差别来自评价方法,不代表智能体运行能力突然下降。开放网页不断变化,用户请求也不总有固定答案,裁判若只阅读最终陈述,容易把看似完成的任务当成真正成功。
Universal Verifier 会按任务生成评分准则,从轨迹中选择与各项准则相关的截图,再结合动作和最终陈述检查环境状态。它分别判断部分过程进展与最终是否完成:用户没有要求的酒店价格不应成为扣分项,中间一次失误也不应污染后续所有评分;商品缺货则需要与智能体自身失败区分。团队利用人工标注和留出轨迹检验方法,结果仍应按提出者的报告理解。
这与模型路由实验形成一个实用连接:要判断低成本方案是否保住效果,首先需要可信的任务结果。浏览器自动化里,点击了按钮、生成了回答、页面真的改变,是不同层面的证据。更可靠的评测从用户要求出发,确认重要状态确实成立,再讨论成功率。产品团队可以因此把含糊的满意判断拆成可观察的完成条件,让改进的方向更清楚。
AI 智能体该持有多少凭据?零个——Docker 的 Jim Clark 谈沙箱与 MCP 网关
来源:AI Engineer · BestBlogs 评分:89

Docker 工程师 Jim Clark 将长期自主工作拆成运行循环、沙箱与工具能力,提出尽量让智能体不直接持有凭据。新闻编辑流程可以把开放检索、事实核查和正式发布分进不同沙箱;负责接触未过滤信息的阶段,不必同时拥有发布权限。编码智能体的 Git 签名密钥也只在提交时需要。把权限放到任务阶段,能够更具体地缩小每次执行的访问范围。
他的方案是在每个沙箱设置一个 MCP 网关入口,统一控制工具、资源、提示词、网络和凭据,让团队能够更换不同的运行框架。与 Okta 合作的 Cross App Access,则尝试利用已有企业身份和授权体系管理访问。这是一场架构与产品方案说明,没有提供独立安全改善的测量;但网关的位置、权限何时开放,以及哪些环节应当分离,都已成为可讨论的设计选择。
10 月 4 日早报中的 Docker 分享侧重微型虚拟机隔离执行环境,这次新增的是身份、凭据与任务授权。隔离决定任务能在哪个环境里运行,授权决定它在这个环境里能访问什么。把两层一起考虑,团队就可以逐步开放能力,同时保留对敏感动作的控制。长时间自主执行所需要的治理,可以从这些具体边界开始建立,而不必依赖人一直坐在旁边逐次确认。
让 Claude Code 写推理引擎,解码比 vLLM 快 90%
来源:AINLP · BestBlogs 评分:89
AINLP 转述 Baseten 工程师 Shawn Rushefsky 的实验:以 MetaInfer 的知识组织方法为起点,让 Claude Code 为固定模型和硬件生成专用推理引擎。单张 B200、Qwen-3.6-35B-A3B 与 NVFP4 精度构成明确条件;在适合推测解码的重复、结构化文本上,单流解码从 vLLM 的 943 提高到 1792 token/s,约快 90%。这些项目仍是实验,没有承接生产流量。
任务准备包括论文、仓库、硬件访问、量化与全精度权重,以及真实服务端点的压测工具。智能体持续生成实现、接受规格与正确性检查,再根据运行结果修改;工程师会调整方向,并确认涉及数值结果的改动。并发 32 时,单副本输出吞吐也从 6030 提高到 10307 token/s。对照是 vLLM 0.25.1,完整配置和消融没有公开,不能把提升归结为某一项优化。
与通用引擎需要覆盖多种模型和硬件不同,这个实验把题目限定在固定部署条件,让优化反馈足够明确。对于长期服务相同模型的团队,可以进一步计算:一次性的开发与 GPU 实验开销,能否换来持续的吞吐收益?它让专用实现成为一个更具体的工程选项,也显示知识契约、真实压测和正确性检查怎样共同约束编码智能体的探索。
Mistral Large 4 发布:多模态能力与开放权重计划
来源:Simon Willison's Weblog · BestBlogs 评分:85
Simon Willison 解读 Mistral Large 4 的预览发布:模型有 1 万亿总参数、490 亿活跃参数,训练使用 Mistral 自有的 3800 块 NVIDIA Grace Blackwell GPU 集群。目前可用的是 API 预览,开放权重则计划在本月底提供。这两个时间点需要区分:开发者已经可以试用接口,还不能据此认为权重已经可以下载和自托管。
作者比较 API 提供的 none 与 high 两档推理设置,用模型生成 SVG 鹈鹕代码,再查看渲染结果。他认为高推理档表现更好,并指出其输出 token 反而少于无推理档。这是具体代码生成任务中的观察,不能改写成模型新增了原生图像生成能力。文章还引用 Artificial Analysis 的 38 分,认为相较 Large 3 有明显进步,评分与个人实测分别提供不同角度的信息。
这条内容的价值,在于把厂商发布与可见测试放到一起。总参数和活跃参数帮助理解模型规模,API 与开放权重计划说明部署路径,实际输出则提供一个可以亲自检验的样例。选择新模型时,既可以看它相较前代改善了多少,也需要判断它在自己的任务上能否交付更好结果。发布节奏和具体任务表现,值得作为两条并行的观察线。
如何为知识工作构建安全的智能体:Every 的共享工作流、评测与权限实践
来源:Claude · BestBlogs 评分:89
Every 在 Claude 的一手访谈中,解释团队为何从各自维护的 OpenClaw 转向公司共享的 Slack 智能体。同事能看见彼此如何提问,并复用已经有效的技能。福利投保场景中,智能体结合公司计划与个人情况帮助比较;编辑场景里,Kate Bench 则把主编约 3 万次历史修改转成 Google Docs 中可审核的建议,再把后续人工修订继续纳入技能。
团队认为,通用模型榜单衡量不了特定组织的品味,因此收集成员喜欢或否定的输出,把理由转成任务检查项,用真实工作比较模型。智能体在 Slack 中有独立身份,工具执行时通常使用请求者的权限;记忆与沙箱可以按不同请求控制。自行维护沙箱遇到困难后,Every 使用 Claude Managed Agents 的沙箱、记忆与会话控制,访谈中的成效来自实践者自述。
这个案例把组织采用 AI 的过程落在可见行为上:提示从私人对话走向共享空间,编辑经验从个人判断走向可审核建议,反馈又进入下一轮工作。与 Acemoglu 对一线知识和细分应用的讨论相接,它说明应用可以围绕已有专业能力成长。团队不必只问哪个模型最强,还可以问,哪些经验值得变成共同技能,哪些反馈能够持续改善这些技能。
延伸探索
算力投入与实际交付,可以沿着 10 月 5 日早报 的 Crusoe 成本访谈继续理解。那一期把注意力放在折旧、能源与交付的经济问题,今天 Google 则解释实际负载的有效产出。前者帮助判断投入,后者帮助理解运行损耗;把这两种视角对照,容量规划就能同时考虑账单和用户最终拿到的结果。
代码生成之后的评价与交付,可连接 10 月 6 日早报 的 ReviewBench 和生产故障诊断。GitHub 的基础设施文章讨论变更如何被保存与协调,浏览器验证器则讨论结果怎样被判定。它们各自处理不同环节,但共同提供了一条工作检查路径:任务完成以后,是否留下足够的状态和证据,让后续系统能够接着工作,让团队能够判断完成质量?
长期工作流可以延伸到站内的 Pi 1.0:为何接纳 MCP,又推出 Pi Durable?。相关介绍讨论标准化工具连接、按需检索工具定义,以及跨进程保留会话状态。将它与今天 Docker 的权限控制和 Every 的共享技能一起看,可以分别理解连接能力、管理访问和保留经验。团队工作方式的持续改进,需要这些环节配合,也需要一线成员把真实需求和反馈带进来。
今日小结
回顾今天的内容,Google 提供有效算力的判断尺度,GitHub 展示并发开发怎样改变交付架构,Acemoglu 则把技术收益放回数据、应用和人的工作。后面的案例进一步说明,检索配置、模型路由、可信评价与分阶段授权,都能成为具体的改进起点。
时间有限,可以先读与你当前瓶颈最接近的一篇:服务扩容看 Google 与路由实验,交付排队看 GitHub,组织采用看 Acemoglu 与 Every。需要调整评测或自主权限时,再读浏览器验证器和 Docker 的机制,比逐个追逐模型参数更容易得到明确的下一步。
欢迎把这期分享给正在搭建 AI 工作流的同事,也欢迎在评论区讨论一个具体问题:现在最需要改善的是任务执行速度、结果验证,还是团队经验的传播?哪些一线知识已经进入工具,哪些仍停留在个人脑海?这些具体反馈,能帮助我们判断新的能力怎样真正进入工作。
👉 近期早报
- BestBlogs 早报 · 2026-10-06
- BestBlogs 早报 · 2026-10-05
- BestBlogs 早报 · 2026-10-04
- BestBlogs.dev 第 115 期:贴身的智能
- BestBlogs.dev 第 114 期:过剩与短板
- BestBlogs.dev 第 113 期:模型之外的尺子
BestBlogs 是 AI 驱动的私人阅读助手,帮助你发现真正适合你的高质量内容,关注你感兴趣的来源和主题,每天生成一份更适合自己的「我的早报」,欢迎体验和关注我们。
— Originally published at x.com
Want this in your inbox every morning?
Daily brief at your local 8am — bilingual EN/中文, free.
More from WebSearch (Tavily)
See more →全球AI芯片峰会,9月上海见!
The 2026 Global AI Chip Summit will take place in Shanghai on September 22-23, focusing on the evolving AI chip landscape, including the shift from training to inference, the rise of diverse chip technologies, and the restructuring of industry competition. Notable speakers include experts from leading universities and companies, discussing advancements in AI chip architecture and applications.